Modell · 2× DGX Spark
KI:KUBE 2 / KI:KUBE 2-slim
Einstieg in lokale Frontier-KI, für kleinere Teams ohne Kompromiss bei der Datenhoheit.
Indikativer Wert: die tatsächliche Nutzer-/Stream-Kapazität hängt sehr von der Modellwahl ab.
Investitionswege & TCO-Rechner auf /preise.
Positionierung
Wann KI:KUBE 2 die richtige Wahl ist
Das passende Werkzeug, wenn Sie heute mit der Cloud-Compliance kämpfen, das Team aber überschaubar ist.
Typische Käufer: Kleine Kanzleien (5–15 Anwälte), StB/WP-Büros mittlerer Größe, Ingenieurbüros bis ~30 MA, Software-Häuser im Ramp-Up.
Hardware
Spezifikation
- DGX Spark Knoten
- 2×
- GPU-Memory (Unified)
- 256 GB
- Internes Netz
- MikroTik 400GbE-Switch (QSFP56-DD), je Spark 200GbE
- Formfaktor
- 19-Zoll-Rack, 18 HE - alternativ als KI:KUBE 2-slim im kompakten 10-Zoll-Gehäuse
- Leistungsaufnahme
- ~0,3 kW unter Inferenz-Volllast (skaliert aus 4-Node-Lauf)
Highlights
Was diese Stufe besonders macht
Niedrigste Einstiegshürde
22.900 € für den System-Kauf, entspricht ungefähr 15 Monaten ChatGPT Pro für ein 8-Personen-Team.
Volle Compliance-Wirkung
DSGVO, § 203, EU AI Act: strukturelle Lösungen sind unabhängig von der Ausbaustufe.
Upgrade möglich
Upgrade auf KI:KUBE 4 ohne Datenmigration: zwei zusätzliche Spark-Knoten + Topologie-Switch.
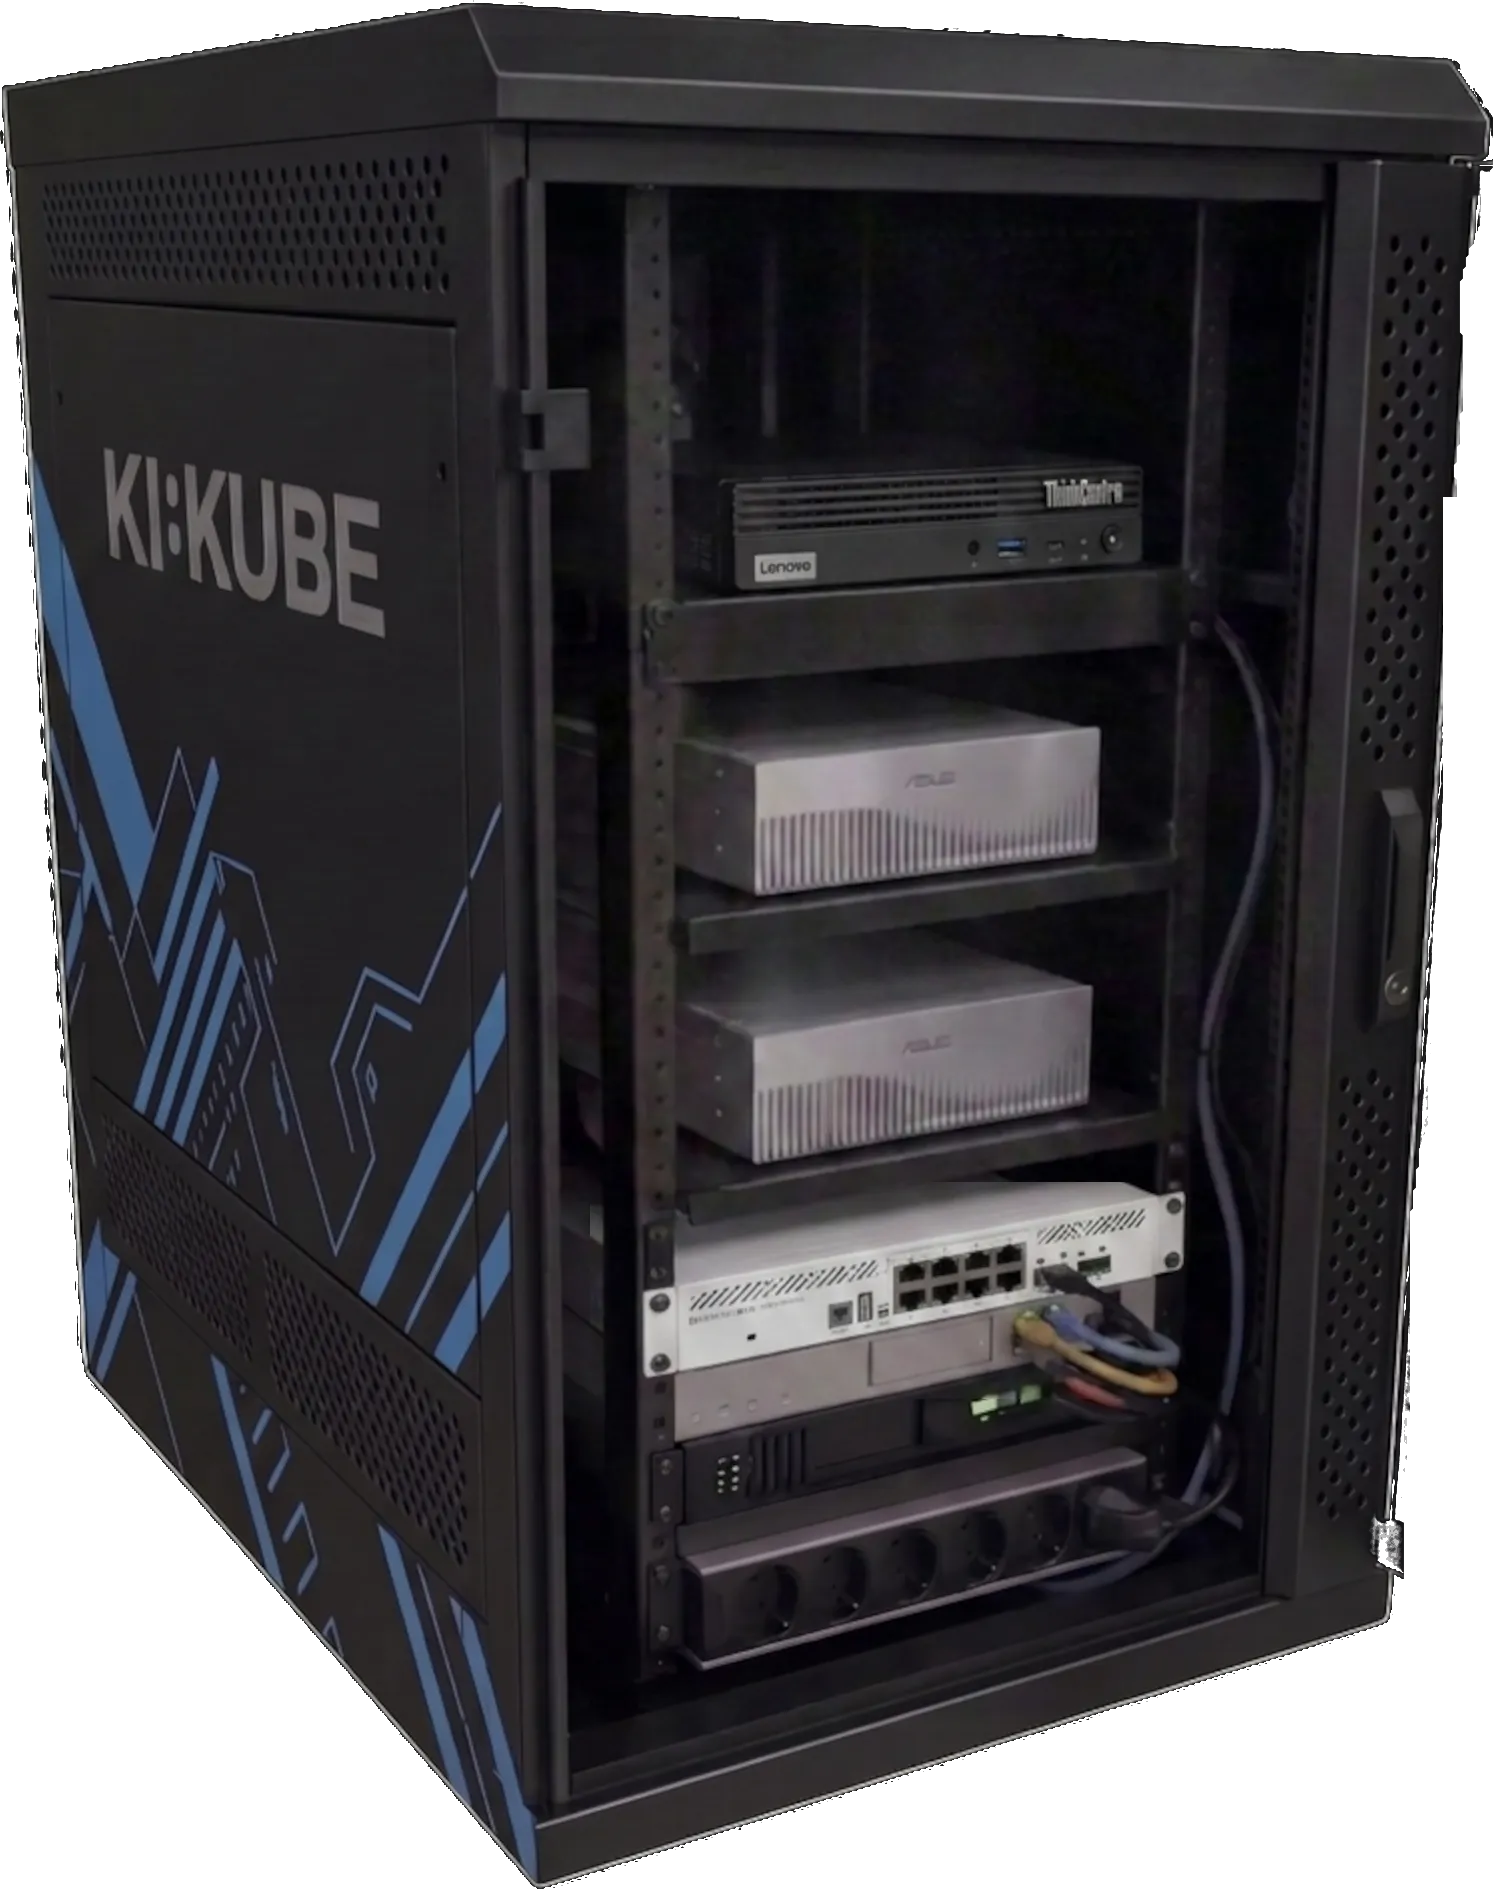
Kompakte Variante
KI:KUBE 2-slim
Gleiche Compute wie die KI:KUBE 2 (zwei DGX Spark, 256 GB Unified Memory) im kompakten 10-Zoll-Gehäuse, ohne dediziertes 400GbE-Inference-Backbone. Der günstigste Einstieg ins KI:KUBE-Ökosystem für kleinere Teams, Edge-Standorte oder als Pilotsystem.
oder als Managed-Service ab 1.611 € / Monat.
- 2× DGX Spark: 256 GB Unified GPU-Memory
- Kompaktes 10-Zoll-Rack statt 18-HE-Schrank
- Eine Schuko-Steckdose, leiser Bürobetrieb
- Gleicher Software-Stack wie KI:KUBE 2 / 4 / 6 / 8
Abweichend von der KI:KUBE 2 entfällt der 400GbE-Inference-Switch: Modell-Auswahl und Throughput entsprechen ansonsten der KI:KUBE 2. Ein direkter Ausbau auf KI:KUBE 4 / 6 ist aus der slim-Variante heraus nicht möglich (fehlender 400GbE-Interconnect-Switch und Platzbedarf im 10-Zoll-Gehäuse), der Umstieg erfolgt über die reguläre KI:KUBE im 18-HE-Rack.
Eignung
Wofür gut, wofür nicht
Empfohlen für
- Modelle bis ~250B Parameter
- Allround-Modell Qwen3.8-Flash-Next-NVFP4 (Reasoning + Tool-Calling, 262K Kontext) oder Qwen3.8-27B-NVFP4 (höchster Durchsatz, ~785 t/s bei n=32)
- RAG-Workloads auf eigenen Dokumenten
- Einzelner Coding-Copilot für 5–15 Devs
Nicht sinnvoll für
- Höchste Frontier-Modelle (>400B Parameter)
- Sehr großes paralleles Coding-Lasting (>30 Devs gleichzeitig im IDE)
- Gleichzeitige Belegung mit zwei großen Modellen ohne Reload
Was läuft darauf?
Beispielhafte Sprachmodelle
Auswahl bekannter Open-Weight-Modelle, die auf dieser Ausbaustufe sinnvoll laufen, die vollständige, validierte Konfiguration ist Bestandteil der Lieferung und wird nicht öffentlich publiziert.
Wichtig: Mit 256 GB Unified Memory laufen auf der KI:KUBE 2 nicht alle großen Modelle. Sinnvoll sind Modelle bis ~250B Parameter (quantisiert). Die größeren Frontier-Modelle (z. B. Qwen3.5-397B, Nemotron-Ultra-550B) benötigen eine KI:KUBE 4 oder 6.
| Sprachmodell | Use Case | Performance (Indikation) |
|---|---|---|
| Qwen3.8-27B-NVFP4 | Dense, höchster Durchsatz auf der KI:KUBE 2 | 78 t/s n=1 · 261 t/s n=4 · 384 t/s n=8 · 785 t/s bei n=32 |
| Qwen3.8-Flash-Next-NVFP4 | Allround: Reasoning + Tool-Calling, 262K Kontext | 55 t/s n=1 · 167 t/s n=4 · 229 t/s n=8 · 485 t/s bei n=32 |
| Nemotron-3-Super-120B-A12B-NVFP4 | Frontier-Reasoning (Mamba2-Hybrid), 512K Kontext | 57 t/s n=1 · 127 t/s n=4 · 178 t/s n=8 · 422 t/s bei n=32 |
| Nemotron-3-Nano-Omni-30B-A3B-NVFP4 | Text + Bild (+ Video/Audio) multimodal | auf 2 Sparks nicht separat gemessen · 4 Sparks: 119 t/s n=1 |
| Gemma 4 26B-A4B-it-BF16 | Vision + Audio (multimodal) | auf 2 Sparks nicht separat gemessen · 4 Sparks: 50 t/s n=1 |
Performance-Werte indikativ, gemessen auf Referenz-Hardware mit SGLang. Tatsächliche Werte hängen von Topologie, Quantisierung, Kontext-Länge und Last ab. Wir besprechen die für Ihren Use-Case relevanten Modelle im Erstgespräch: keine Tabellen-Akrobatik nötig.
Upgrade-Pfad
Erweiterung auf KI:KUBE 4 jederzeit möglich (~10.900 € zusätzlich + Service).
Alternativen
Die anderen Ausbaustufen
KI:KUBE 4
Die Standard-Ausbaustufe: empfohlen für Kanzleien, StB-Büros und mittelständische Software-Häuser.
KI:KUBE 4 ansehen →KI:KUBE 6
Die Pro-Variante: für sehr große Teams, paralleles Multi-Modell oder Frontier-Reasoning ohne Quantisierungs-Kompromiss.
KI:KUBE 6 ansehen →KI:KUBE 8
Das Top-Modell: maximale Unified-Memory-Reserven für die größten Frontier-Modelle in hoher Präzision und parallele Multi-Modell-Bestückung ohne Reload.
KI:KUBE 8 ansehen →KI:KUBE 2 an einem Ihrer eigenen Dokumente sehen.
Demo anfragen